WydarzeniaSztuczna inteligencjaRynekPREZENTACJA PARTNERA
Dane, AI i wiedza, której nie powinno się zamykać za paywallem
Advertorial

Technologia nigdy nie rozwijała się tak szybko jak dziś. W obszarze danych i sztucznej inteligencji kolejne modele, narzędzia i możliwości pojawiają się niemal z miesiąca na miesiąc. Jeszcze niedawno większość dyskusji dotyczyła generatywnej AI, dziś coraz więcej mówi się o agentach AI, agentic engineering czy conversational analytics, automatyzacji pracy z danymi czy wykorzystaniu modeli językowych bezpośrednio w procesach biznesowych. Tempo zmian jest imponujące, ale ma też swoją cenę. Im więcej pojawia się nowych technologii, tym łatwiej skupić się na tym, co nowe i efektowne, a zgubić to, co podstawowe.
A w praktyce to właśnie podstawy nadal decydują o powodzeniu większości projektów. Można mieć dostęp do bardzo zaawansowanego modelu AI, ale jeżeli dane są rozproszone pomiędzy wiele systemów, ich jakość jest trudna do zweryfikowania, a poszczególne działy inaczej definiują te same wskaźniki, możliwości takiego rozwiązania pozostaną ograniczone. Można zbudować agenta AI, który odpowiada na pytania dotyczące biznesu, ale jeśli organizacja nie wie, do jakich informacji powinien mieć dostęp, kto odpowiada za ich aktualność i które źródło jest wiarygodne, szybko pojawią się problemy.
Dlatego przy całym zainteresowaniu AI warto regularnie wracać do kilku prostych pytań: gdzie znajdują się nasze dane, czy można im ufać, jak są ze sobą połączone, kto odpowiada za ich jakość i czy architektura, którą budujemy dzisiaj, pozwoli rozwijać rozwiązania również za dwa lub trzy lata? I wreszcie: czy technologia, którą chcemy wdrożyć, rzeczywiście rozwiązuje problem biznesowy? To pytania znacznie mniej efektowne niż prezentacja kolejnego modelu AI, ale często znacznie ważniejsze.
Wiedza starzeje się szybciej
Zmienia się również sposób, w jaki zdobywamy wiedzę technologiczną. Dokumentacja, szkolenia i certyfikacje nadal są potrzebne, jednak coraz częściej największą wartość mają doświadczenia ludzi, którzy rzeczywiście przeszli przez dane wdrożenie. Nie tylko wiedza o tym, jak coś powinno działać, ale również o tym, co wydarzyło się po drodze: jakie problemy pojawiły się w danych, które założenia trzeba było zmienić, co działało dobrze w środowisku testowym, a przestało działać po uruchomieniu rozwiązania w skali całej organizacji i jakie decyzje architektoniczne po kilku miesiącach trzeba było ponownie przemyśleć.
Takiej wiedzy często nie znajdziemy w dokumentacji produktu. Może pochodzić od Data Engineera, który przez kilka miesięcy modernizował środowisko danych, od firmy, która próbowała wykorzystać AI do pracy z tysiącami dokumentów, albo od zespołu, który musiał połączyć dane z kilkunastu źródeł przed rozpoczęciem projektu analitycznego. Właśnie te doświadczenia pozwalają innym organizacjom szybciej ocenić, co ma sens, a czego lepiej uniknąć.
Nie każdą wiedzę trzeba zamieniać w produkt
Przyzwyczailiśmy się do tego, że duża część wiedzy eksperckiej jest płatna. Raporty, kursy, zamknięte szkolenia, subskrypcje, newslettery premium czy konferencje są naturalnym elementem rynku i często dostarczają dużą wartość. Jednocześnie istnieje obszar wiedzy, której sens polega właśnie na tym, że jest szeroko dostępna – szczególnie wtedy, gdy technologia zmienia się bardzo szybko.
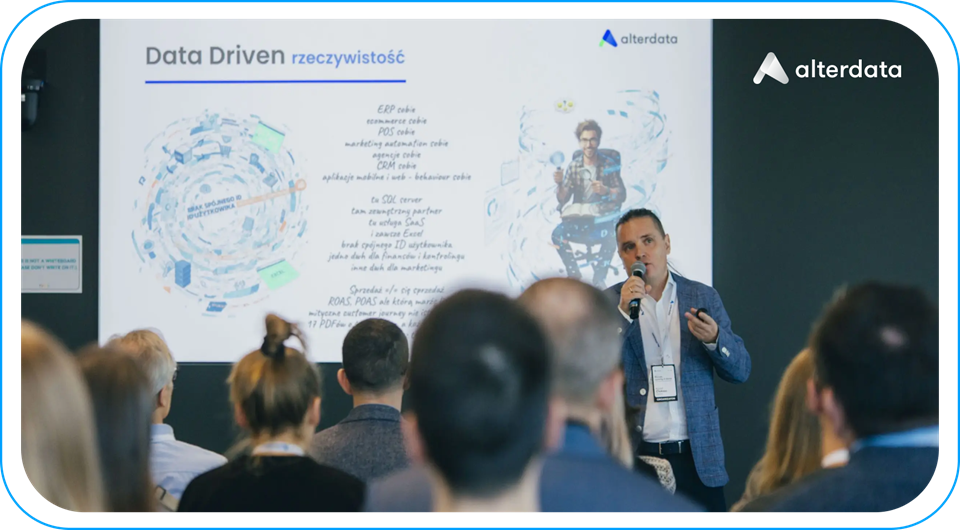
Jeżeli doświadczenia jednego zespołu mogą pomóc innemu uniknąć kilku miesięcy pracy w niewłaściwym kierunku, warto się nimi dzielić. Jeżeli można pokazać, dlaczego określona architektura danych sprawdziła się w jednym przypadku, a w innym wymagała zupełnie innego podejścia, taka rozmowa pomaga całemu rynkowi dojrzewać. Z takiego właśnie założenia powstała organizowana przez nasz zespół Alterdata – konferencja „Biznes oparty o dane”.
Od początku chcieliśmy, aby było to bezpłatne wydarzenie skupione przede wszystkim na praktycznych doświadczeniach związanych z danymi, analityką, chmurą i AI. Nie chodzi o to, żeby przekonywać uczestników, że każda organizacja powinna natychmiast wdrożyć najnowszą technologię. Znacznie ciekawsze jest pokazanie, w jaki sposób konkretne firmy podchodzą do swoich problemów, jakie decyzje podejmują i czego uczą się podczas wdrożeń.
Case study jest ciekawsze od prezentacji produktowej
W technologii bardzo łatwo stworzyć prezentację, na której wszystko wygląda perfekcyjnie. Źródła danych znajdują się po lewej stronie, hurtownia pośrodku, narzędzia analityczne i AI po prawej. Pomiędzy nimi biegną równe strzałki, a cały proces kończy się sukcesem. Rzeczywistość jest zwykle bardziej skomplikowana.
Czasami okazuje się, że dane źródłowe wymagają uporządkowania. Czasami największym problemem jest nie technologia, ale brak wspólnej definicji podstawowego wskaźnika. Innym razem rozwiązanie działa poprawnie, ale dopiero po wdrożeniu okazuje się, że użytkownicy potrzebują zupełnie innego sposobu korzystania z danych. I właśnie dlatego najbardziej interesujące są nie tylko końcowe rezultaty, lecz również droga do nich.
Jak wyglądał punkt wyjścia? Co było największym ograniczeniem? Dlaczego wybrano określone rozwiązanie? Co trzeba było zmienić podczas projektu? Jakie efekty pojawiły się dopiero po kilku miesiącach? To wiedza, którą można później wykorzystać we własnej organizacji.
AI nie rozwiązuje problemu z danymi
Dynamiczny rozwój AI sprawia też, że tematy takie jak architektura danych, jakość, uprawnienia, governance czy semantyka stają się jeszcze ważniejsze. Dobrym przykładem są agenci AI. Możemy wyobrazić sobie agenta, który odpowiada na pytania dotyczące sprzedaży, analizuje dokumenty, przygotowuje raporty albo pomaga pracownikom podejmować decyzje. Ale skąd agent ma wiedzieć, która informacja jest prawidłowa?
Jeżeli w firmie funkcjonuje kilka definicji tego samego wskaźnika, model nie rozwiąże tego problemu. Jeżeli użytkownik nie powinien mieć dostępu do części danych, system AI musi respektować te same zasady. Jeżeli informacje są aktualizowane raz na tydzień, odpowiedź może być poprawna technicznie, ale bezużyteczna biznesowo. AI nie eliminuje więc potrzeby uporządkowania danych. Często wręcz bardzo szybko pokazuje, gdzie organizacja ma z nimi problem.
Dlatego dyskusja o sztucznej inteligencji coraz częściej powinna zaczynać się nie od pytania „jaki model wybrać?”, ale od pytania „czy nasze dane i procesy są gotowe, aby z takiego modelu korzystać?”.
Wiedza powstaje również poza sceną
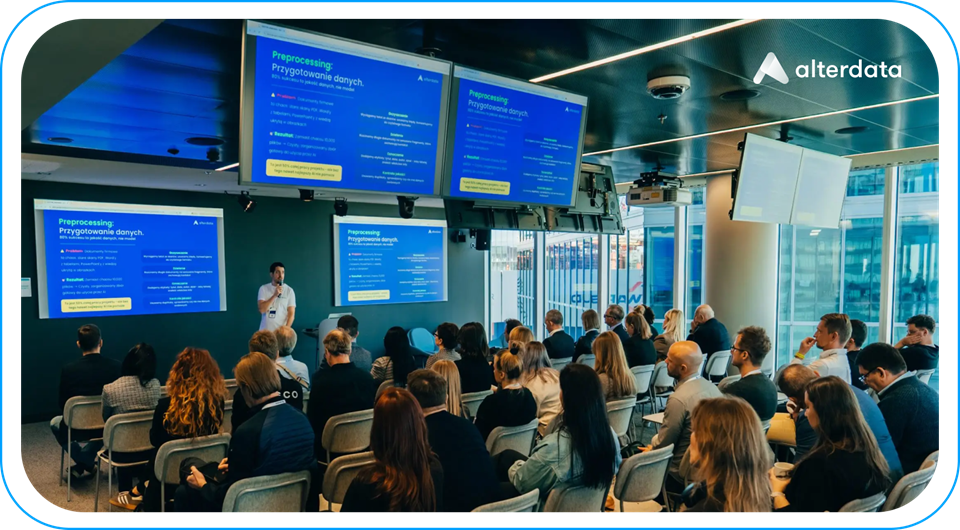
Jednym z powodów, dla których nadal wierzymy w stacjonarne konferencje, jest również to, że najciekawsze rozmowy nie zawsze odbywają się podczas prezentacji. Czasami zaczynają się chwilę po niej. Ktoś mówi: „mamy dokładnie ten sam problem”. Ktoś inny opowiada, jak rozwiązał podobną sytuację w swojej organizacji. Nagle okazuje się, że firmy działające w różnych branżach mierzą się z bardzo podobnymi wyzwaniami.
Jak uporządkować raportowanie? Jak ograniczyć ręczną pracę? Jak przygotować dane pod AI? Jak zdecydować, kiedy budować własne rozwiązanie, a kiedy wykorzystać gotowe narzędzie? Jak modernizować środowisko bez zatrzymywania bieżącej pracy biznesu? Właśnie dlatego konferencję „Biznes oparty o dane” traktujemy przede wszystkim jako miejsce wymiany doświadczeń.
Kolejna edycja odbędzie się 15 października w Warszawie w Campusie Google’a. Będziemy rozmawiać o praktycznych zastosowaniach danych i AI, o architekturze, realnych wdrożeniach oraz o tym, co musi wydarzyć się wcześniej, zanim organizacja zacznie wykorzystywać bardziej zaawansowane rozwiązania.
Udział w wydarzeniu jest bezpłatny. Liczba miejsc jest jednak ograniczona, więc warto spróbować do nas dołączyć. Bo technologia prawdopodobnie nie zwolni. Tym bardziej potrzebujemy miejsc, w których można porównać doświadczenia, wrócić do podstaw i otwarcie porozmawiać o tym, co naprawdę działa. Link do wydarzenia.
Kamil Ciukszo, CEO w Alterdata