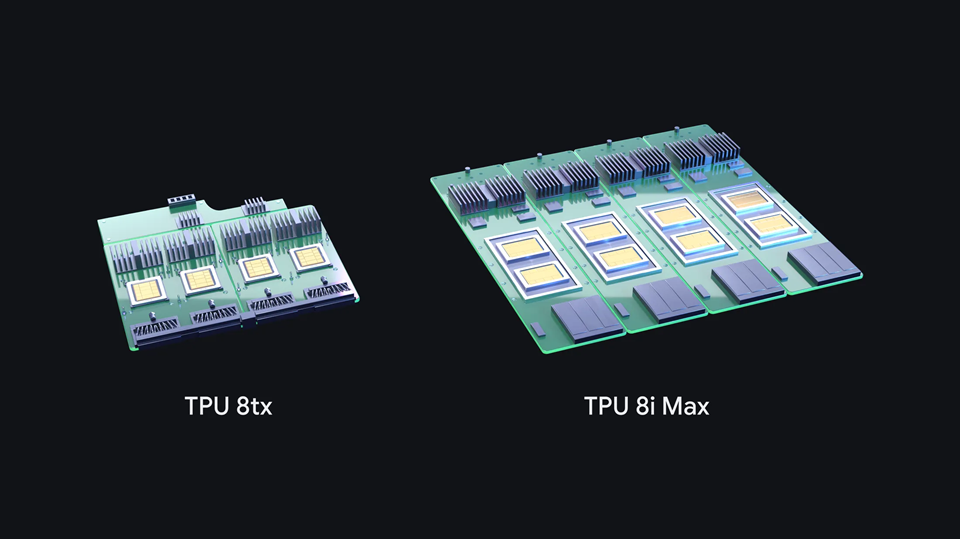
Chodzi o dwa nowe systemy akceleratorów ósmej generacji: TPU 8tx i TPU 8i Max. Pierwszy ma zapewnić ochronę danych podczas ich przetwarzania, drugi zwiększyć wydajność pracy z bardzo dużymi oknami kontekstowymi. Koncern rozwija w ten sposób infrastrukturę przeznaczoną do trenowania i obsługi agentów AI. Nowe konfiguracje uzupełniają TPU 8t i TPU 8i, zaprezentowane w kwietniu tego roku.
Akceleratory Google służą do trenowania i uruchamiania modeli Gemini, obsługi usług Google Cloud oraz zadań realizowanych przez agentów AI. Firma oferuje je również klientom, którzy chcą wdrażać własną infrastrukturę w centrach danych. Według informacji Google, z rozwiązań TPU korzysta już blisko 100 klientów, w tym twórcy zaawansowanych modeli AI, firmy handlowe, instytucje finansowe i uczelnie.
TPU 8tx: dane chronione także podczas przetwarzania
Tradycyjne mechanizmy szyfrowania chronią informacje podczas przechowywania i przesyłania, ale w trakcie obliczeń dane muszą zostać odszyfrowane w pamięci. Google przenosi zabezpieczenia na poziom sprzętu, tak aby informacje i wagi modeli pozostawały chronione również podczas przetwarzania.
Nowy TPU 8tx powstał z myślą o instytucjach rządowych i przedsiębiorstwach działających w regulowanych sektorach. Ma umożliwić uruchamianie zaawansowanych modeli i agentów AI bez narażania wrażliwych danych. TPU 8tx bazuje na tym samym układzie krzemowym co TPU 8t i współpracuje z procesorami AMD EPYC piątej generacji. Wykorzystuje też sieć Boardfly, zaprojektowaną z myślą o ograniczaniu opóźnień. Według specjalistów Google, pozwala ona uzyskać nawet dwukrotnie niższe opóźnienia niż w TPU 8t, przy niemal zerowym spadku wydajności.
System umożliwia także trenowanie i dostrajanie modeli w tym samym środowisku, bez przenoszenia poufnych danych między oddzielnymi klastrami obliczeniowymi. Firmy mogą wykorzystywać własne informacje do dostrajania modeli, tworzyć mniejsze wersje większych systemów AI oraz rozwijać agentów z użyciem uczenia ze wzmocnieniem.
TPU 8i Max: więcej pamięci dla dużych modeli
Drugi nowy system, TPU 8i Max, odpowiada na ograniczenia związane z przepustowością pamięci. Problem staje się szczególnie widoczny, gdy wielu agentów jednocześnie analizuje duże zbiory danych. Przykładowo, całe repozytoria kodu lub wielogodzinne nagrania wideo.
Google połączyło dwa układy TPU 8i w jednym module. W porównaniu ze standardowym TPU 8i nowa konfiguracja oferuje dwukrotnie większą moc obliczeniową, dwa razy więcej pamięci SRAM i dwukrotnie wyższą przepustowość pamięci HBM. Ma to ograniczyć przestoje wynikające z oczekiwania procesorów na dostęp do danych. TPU 8i Max pozwala również zwiększyć gęstość obliczeniową w centrach danych. Jak wskazują eksperci Google, system mieści dwukrotnie więcej układów krzemowych w tej samej przestrzeni szafy serwerowej.
Cztery konfiguracje do różnych zadań AI
Jak już wspomniano, nowe systemy uzupełniają portfolio zaprezentowane w kwietniu br. TPU 8t służy do trenowania dużych modeli bazowych, a TPU 8i zaprojektowano z myślą o wnioskowaniu i ograniczaniu opóźnień. W porównaniu z poprzednią generacją TPU pierwszy zapewnia do 2,7 raza wyższą wydajność trenowania, a drugi do 80% lepszy stosunek wydajności do ceny podczas wnioskowania.
Pozostałe konfiguracje odpowiadają na bardziej wyspecjalizowane potrzeby. TPU 8tx zapewnia ochronę danych podczas obliczeń, natomiast TPU 8i Max zwiększa możliwości pracy z dużymi oknami kontekstowymi i gęstość obliczeniową.
Google rozwija przy tym również oprogramowanie i narzędzia ułatwiające korzystanie z własnych akceleratorów. Firma zapowiedziała między innymi otwarcie kodu Torchtpu, co ma uprościć uruchamianie natywnych aplikacji PyTorch na układach TPU.