Sztuczna inteligencjaPolecane tematy
Luka obliczeniowa na uczelniach zmniejsza ich wpływ na kierunki rozwoju AI

Rozwój AI coraz wyraźniej dzieli środowisko badawcze na tych, którzy mają dostęp do ogromnej mocy obliczeniowej, danych i zespołów inżynierskich, oraz tych, którzy mogą jedynie obserwować najważniejsze przełomy z dystansu. Najnowsze analizy wskazują, że nie jest to już wyłącznie problem budżetów uczelni czy dostępności kart graficznych.
Raport „The Compute Divide in Machine Learning: A Threat to Academic Contribution and Scrutiny?” – autorstwa Tamaya Besiroglu i współautorów – pokazuje, że wraz ze wzrostem znaczenia wielkich modeli językowych i innych modeli fundamentalnych, uczelnie tracą pozycję w najbardziej kapitało- i infrastrukturochłonnych segmentach badań.
Z kolei artykuł w „Nature” zwraca uwagę, że ograniczony dostęp do zaawansowanych układów obliczeniowych oraz superkomputerów jest dziś jednym z głównych źródeł frustracji badaczy AI na uczelniach na całym świecie. Brak dostępu do mocy obliczeniowej wyznacza to, kto może niezależnie testować najbardziej wpływowe modele oraz kto ma realny udział w kształtowaniu standardów bezpieczeństwa i odpowiedzialności.
Stawką więc jest nie tylko prestiż naukowy. Chodzi o zdolność niezależnych instytucji do weryfikowania technologii, która coraz szybciej trafia do biznesu, administracji publicznej, edukacji, ochrony zdrowia i codziennego życia.
Przemysł przejął skalę projektów rozwoju AI
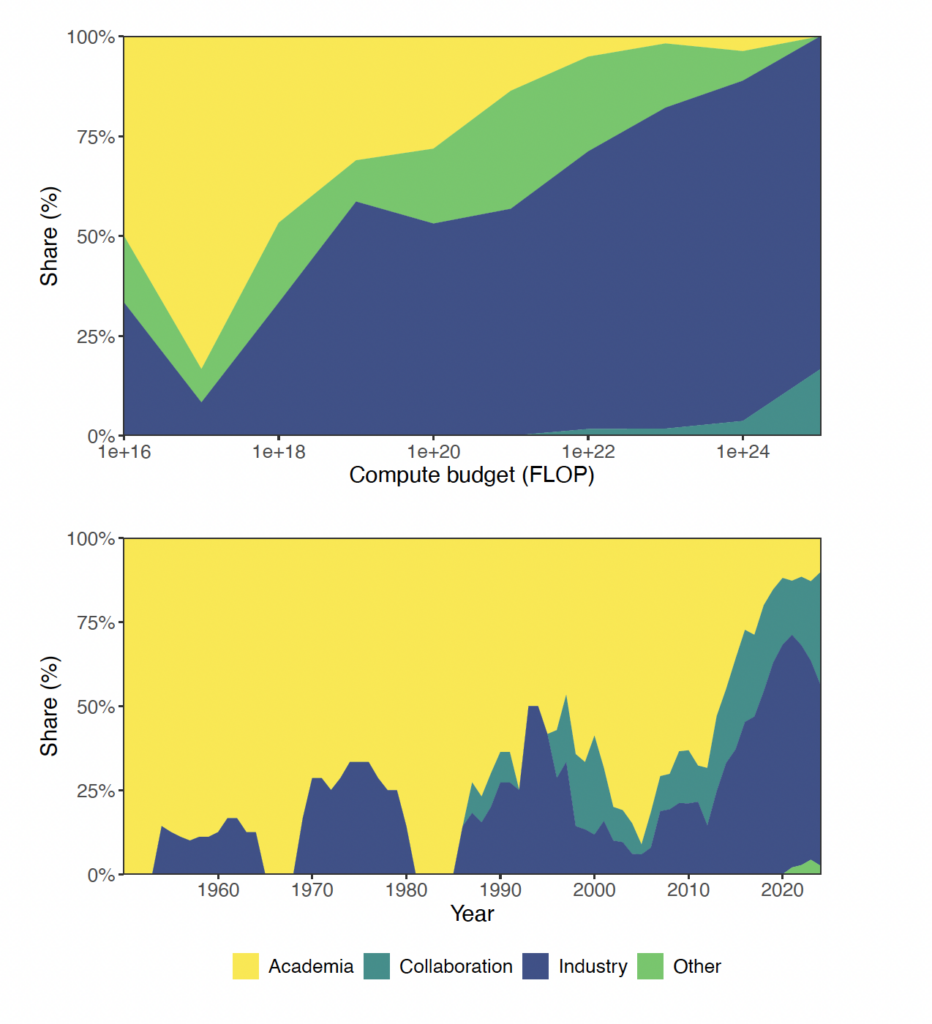
Autorzy opracowania analizują dane dotyczące ponad 650 znaczących modeli uczenia maszynowego. Wniosek jest jednoznaczny: udział zespołów akademickich w tworzeniu najbardziej wymagających obliczeniowo modeli gwałtownie zmalał.
Na początku poprzedniej dekady ok. 65% modeli zaliczanych do najbardziej intensywnych obliczeniowo powstawało w laboratoriach akademickich. Na początku lat 20. XXI wieku udział ten spadł do ok. 10%. Od 2017 roku zespoły przemysłowe dominują w trenowaniu modeli o największej skali. W 2022 roku odpowiadały już za ok. 81% takich projektów.
To przesunięcie ma szczególne znaczenie w przypadku modeli fundamentalnych: dużych modeli językowych, generatywnych modeli obrazu czy systemów trenowanych na ogromnych zbiorach danych. Ich rozwój wymaga nie tylko tysięcy czy dziesiątek tysięcy układów GPU / TPU, ale też specjalistycznej wiedzy w zakresie treningu rozproszonego, równoległości modeli, zarządzania pamięcią, niezawodności infrastruktury i optymalizacji kosztów.
Przewaga firm technologicznych nie polega już wyłącznie na możliwości opłacenia pojedynczego treningu. Najwięksi gracze dysponują centrami danych, relacjami z dostawcami chmury, własnymi platformami obliczeniowymi, inżynierami infrastruktury oraz dostępem do danych i środowisk produkcyjnych. Uczelniany zespół może mieć wybitny pomysł, ale niekoniecznie środki, aby sprawdzić go w skali porównywalnej z laboratoriami największych firm.
Różnicę dobrze ilustrują dane z konferencji NeurIPS 2021. Zespoły z udziałem autorów przemysłowych deklarowały wykorzystanie sprzętu średnio ok. 5 razy wydajniejszego niż zespoły niepowiązane z biznesem. Co więcej, ok. 30% zespołów przemysłowych miało lepszą infrastrukturę niż najlepsze konfiguracje akademickie.
Problem większy niż tylko dostęp do GPU
Trenowanie bardzo dużych modeli stało się przedsięwzięciem inżynierskim, porównywalnym raczej z budową złożonego produktu technologicznego niż z tradycyjnym eksperymentem realizowanym przez doktoranta lub kilkuosobowy zespół. Wymaga wdrażania technik takich, jak równoległość modelu i potoku, efektywne zarządzanie pamięcią czy monitorowanie awarii sprzętowych. Autorzy raportu podkreślają, że akademia często nie ma ani budżetu, ani trwałych zespołów technicznych niezbędnych do obsługi takiej infrastruktury (mówią o tym też uczelnie w Polsce).
Na początku poprzedniej dekady ok. 65% modeli zaliczanych do najbardziej intensywnych obliczeniowo powstawało w laboratoriach akademickich. Na początku lat 20. XXI wieku udział ten spadł do ok. 10%. Od 2017 roku zespoły przemysłowe dominują w trenowaniu modeli o największej skali. W 2022 roku odpowiadały już za ok. 81% takich projektów.
W artykule „Nature” problem przedstawiono jako zjawisko globalne: badacze z uczelni wskazują, że brak dostępu do wysokowydajnych układów i zasobów obliczeniowych utrudnia im prowadzenie konkurencyjnych badań w AI. Nie oznacza to, że uniwersytety przestają tworzyć wartościową naukę. Oznacza natomiast, że maleje ich zdolność do uczestniczenia w najbardziej zaawansowanej części wyścigu technologicznego.
Powstaje więc strukturalna asymetria. Przemysł nie tylko szybciej buduje coraz większe modele, lecz także zyskuje przewagę w definiowaniu tego, jakie problemy uznaje się za ważne, jakie benchmarki stają się standardem i które metody są rozwijane.
Przemysł zmienia agendę badawczą
Jednym z najciekawszych wniosków publikacji jest to, że luka obliczeniowa zmienia samą mapę badań nad AI. Autorzy wykorzystali dane z OpenAlex, obejmujące ok. 1,2 mln publikacji w 25 najważniejszych podobszarach Machine Learning. Stwierdzili, że wzrost liczby pojęć związanych z obliczeniami – takich, jak GPU, skalowanie, systemy rozproszone czy infrastruktura – wiąże się ze spadkiem udziału publikacji tworzonych wyłącznie przez zespoły akademickie.
W latach 2012-2021 wzrost o 10% częstości występowania terminów obliczeniowych w abstraktach wiązał się średnio ze spadkiem udziału publikacji akademickich w danym obszarze o 1,73%. Zależność była jeszcze silniejsza w dziedzinach językowych. W przetwarzaniu języka naturalnego spadek wynosił 2,43%, w modelowaniu języka 2,76%, a w tłumaczeniu maszynowym 2,18%.
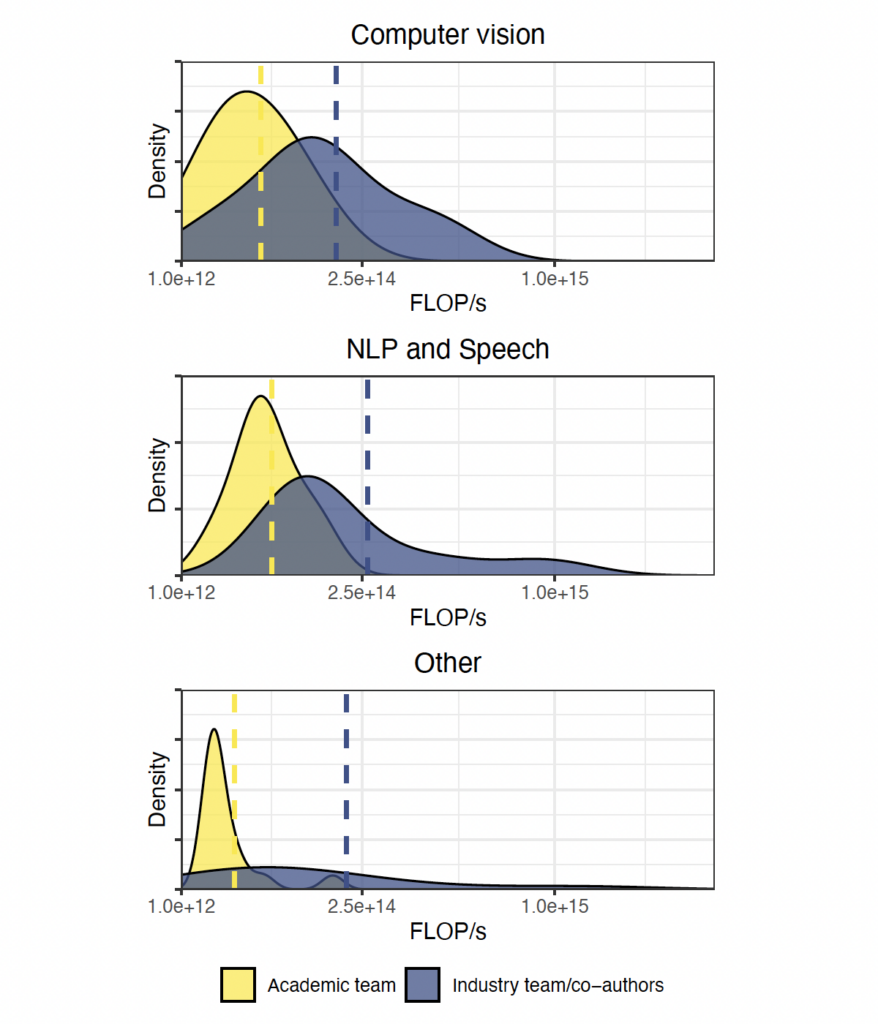
Rozkład szczytowej teoretycznej wydajności (FLOP/s) sprzętu wykorzystanego w 2333 artykułach z konferencji NeurIPS 2021. Linie przerywane przedstawiają średnią szczytową teoretyczną wydajność konfiguracji sprzętowych opisanych w pracach zespołów akademickich oraz zespołów badawczych z udziałem autorów z przemysłu. Kategoria „Inne” obejmuje tematykę wykraczającą poza NLP, przetwarzanie mowy i widzenie komputerowe (np. uczenie ze wzmacnianiem, prace metodologiczne, grafowe sieci neuronowe oraz publikacje dotyczące wielu poddziedzin).
Nie oznacza to, że badania akademickie stają się mniej istotne. Zmienia się jednak ich profil. Uczelnie mogą częściej koncentrować się na problemach mniej wymagających sprzętowo, na analizie istniejących modeli albo na zastosowaniach, które nie są bezpośrednio atrakcyjne komercyjnie. To może być korzystne tam, gdzie ważne są badania podstawowe, interpretowalność, bezpieczeństwo, wykluczenie cyfrowe, języki o mniejszych zasobach danych, zdrowie publiczne czy klimat.
Ryzyko polega na tym, że obszary o największym potencjale technologicznym i biznesowym (zwłaszcza rozwój modeli fundamentalnych) będą coraz silniej kształtowane przez kilka firm („laboratoriów AI”)posiadających kapitał i infrastrukturę. W konsekwencji publiczne instytucje mogą zostać zepchnięte z roli współtwórców do roli użytkowników, komentatorów lub odbiorców gotowych technologii.
Uczelnie badają cudze modele
Naturalną odpowiedzią na ograniczony dostęp do mocy obliczeniowej jest korzystanie z modeli udostępnianych przez przemysł. Otwarte frameworki, biblioteki, dane, kod oraz wagi – wstępnie wytrenowanych modeli – znacząco obniżają próg wejścia. Badacze nie muszą zaczynać od kosztownego treningu od zera. Mogą dostosowywać, testować, analizować i porównywać istniejące modele.
Przewaga firm technologicznych nad uniwersytetami nie polega już wyłącznie na możliwości opłacenia pojedynczego treningu. Najwięksi gracze dysponują centrami danych, relacjami z dostawcami chmury, własnymi platformami obliczeniowymi, inżynierami infrastruktury oraz dostępem do danych i środowisk produkcyjnych.
Najlepszym przykładem jest BERT, udostępniony przez Google w 2018 roku. Według autorów raportu, liczba publikacji na konferencji NeurIPS, które rzeczywiście badały BERT lub modele z jego rodziny, wzrosła z 20 w 2019 roku do 65 w 2021 roku. W 2021 roku stanowiły one ok. 3% wszystkich publikacji konferencyjnych.
To zjawisko ma dwie strony. Z jednej modele otwarte przyspieszają badania, ułatwiają replikację wyników i pozwalają małym zespołom pracować na zaawansowanych architekturach. Z drugiej zaś technologia udostępniona przez firmę może wyznaczać standardy, narzucać architektury i wpływać na pytania badawcze.
Uczelnie zyskują narzędzia, ale jednocześnie stają się zależne od decyzji dotyczących tego, co firmy zdecydują się udostępnić: model, kod, dane, dokumentację, interfejs API czy jedynie ograniczony dostęp do usługi. W najważniejszych systemach granicznych, najdroższych i najbardziej zaawansowanych, pełna otwartość staje się raczej wyjątkiem niż regułą.
Zmniejszony dostęp, to mniejsza kontrola
Najpoważniejszą konsekwencją luki obliczeniowej na uniwersytetach jest ograniczenie niezależnej kontroli nad modelami AI. Jeśli najbardziej wpływowe systemy powstają w firmach i pozostają niedostępne dla zewnętrznych badaczy, trudniej ocenić ich ograniczenia, uprzedzenia, podatność na manipulacje, ryzyka dla prywatności czy skutki społeczne.
Najpoważniejszą konsekwencją luki obliczeniowej na uniwersytetach jest ograniczenie niezależnej kontroli nad modelami AI. Jeśli najbardziej wpływowe systemy powstają w firmach i pozostają niedostępne dla zewnętrznych badaczy, trudniej ocenić ich ograniczenia, uprzedzenia, podatność na manipulacje, ryzyka dla prywatności czy skutki społeczne.
Autorzy publikacji zwracają uwagę na różnice w praktykach udostępniania kodu. W próbie 94 prac z konferencji NeurIPS prezentujących nowe modele, zespoły w pełni przemysłowe były ok. 32% mniej skłonne do publikowania kodu niż zespoły wyłącznie akademickie. Analiza regresji wskazała, że przy przejściu od 0% do 100% udziału autorów z przemysłu prawdopodobieństwo zgłoszenia kodu spadało o ok. 32,45%.
Firmy mają zrozumiałe powody, aby ograniczać otwartość – ochronę własności intelektualnej, przewagi konkurencyjnej, poufnych danych, bezpieczeństwa lub ryzyka nadużyć. Jednak z perspektywy interesu publicznego ograniczona dostępność modeli, danych i kodu utrudnia niezależną replikację wyników oraz testowanie twierdzeń dotyczących bezpieczeństwa i niezawodności.
Właśnie tu wyjątkowa rola uczelni staje się najbardziej widoczna. Badacze spoza firm mogą prowadzić analizę mniej podporządkowaną celom produktowym, harmonogramom wdrożeń i presji konkurencyjnej. Mogą zadawać niewygodne pytania: kto ponosi koszty błędów, jak model zachowuje się wobec mniejszości językowych, czy deklarowane zabezpieczenia działają w praktyce, jakie szkody mogą wyniknąć z wdrożenia na masową skalę?
Jak zmniejszać lukę dostępu do zasobów?
Autorzy nie postulują prostego wyrównania wyścigu na największe modele. Zamiast tego proponują „odpowiedzialne dostarczanie mocy obliczeniowej”. Mają to być publiczne programy zapewniające zasoby obliczeniowe tam, gdzie rynek może nie dostarczać ich w wystarczającym stopniu.
Priorytetem powinny być badania nad interpretowalnością modeli, bezpieczeństwem, odpornością na ataki, oceną ryzyk, ochroną prywatności oraz zastosowaniami o wysokiej wartości społecznej, lecz mniejszej atrakcyjności komercyjnej. Chodzi m.in. o narzędzia dla ochrony zdrowia, nauki o klimacie, chorób zaniedbanych, usług publicznych czy języków słabiej reprezentowanych w zasobach cyfrowych.
W tym kontekście szczególne znaczenie mają narodowe i ponadnarodowe programy infrastrukturalne, takie jak amerykański National AI Research Resource, brytyjskie inicjatywy rozwoju zasobów AI czy inwestycje w Unii Europejskiej koordynowane przez EuroHPC Joint Undertaking takie, jak budowa Fabryk AI, w których bierze udział też Polska.
Priorytetem na uczelniach powinny być badania nad interpretowalnością modeli, bezpieczeństwem, odpornością na ataki, oceną ryzyk, ochroną prywatności oraz zastosowaniami o wysokiej wartości społecznej, lecz mniejszej atrakcyjności komercyjnej. Chodzi m.in. o narzędzia dla ochrony zdrowia, nauki o klimacie, chorób zaniedbanych, usług publicznych.
W europejskiej debacie problem ten łączy się bezpośrednio z cyfrową suwerennością: dostępem do infrastruktury, kompetencji, danych i zdolności do prowadzenia niezależnych badań nad technologiami o strategicznym znaczeniu.
Drugim postulatem jest rozwój uporządkowanego, uprzywilejowanego dostępu do modeli. Nie każdy system musi zostać w pełni otwarty, ale niezależni badacze, instytucje publiczne, organizacje społeczne i audytorzy powinni mieć możliwość kontrolowanego testowania modeli wysokiego ryzyka. Taki dostęp może obejmować bezpieczne środowiska badawcze, limity użycia, monitoring oraz zasady zapobiegające kopiowaniu modeli lub ich niewłaściwemu zastosowaniu.
Trzecim elementem są niezależne audyty. Jeśli uczelnie nie są w stanie odtworzyć treningu najpotężniejszych modeli, potrzebne są inne mechanizmy pozwalające sprawdzać deklaracje firm rozwijających najpotężniejsze modele AI dotyczące bezpieczeństwa, ochrony prywatności, odporności systemów i uczciwości ich działania. Audyt nie zastąpi otwartej nauki, ale może stworzyć minimalny poziom rozliczalności tam, gdzie pełna transparentność nie jest możliwa.
Luka obliczeniowa nie jest więc pobocznym problemem technicznym. To kwestia wpływu, wiarygodności i kontroli nad jedną z najważniejszych technologii współczesności. Jeżeli dostęp do infrastruktury pozostanie skoncentrowany w rękach nielicznych firm, również zdolność do definiowania przyszłości AI będzie skoncentrowana. A bez silnej, niezależnej akademii trudniej będzie zapewnić, że rozwój sztucznej inteligencji służy nie tylko tym, którzy mogą sfinansować jej największe modele.