WydarzeniaSztuczna inteligencjaPolecane tematy
Skalowanie, wyjaśnialność i człowiek w centrum. Wręczono nagrody im. Witolda Lipskiego za ważne badania nad AI

Młodzi, polscy naukowcy nagrodzeni prestiżową nagrodą za swoje badania nad AI. Wynik pracy jednego z nich teoretycznie może wstrząsnąć światową giełdą.
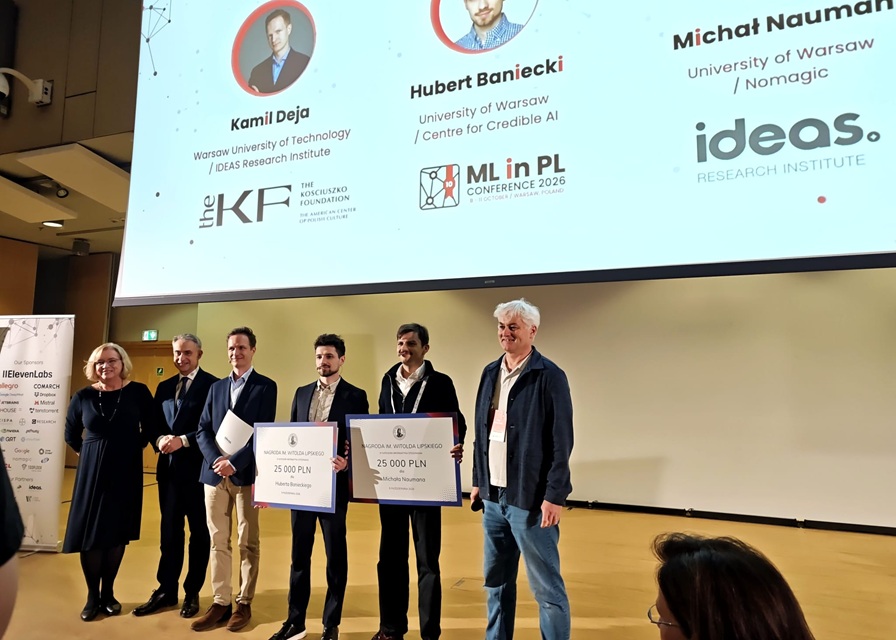
Podczas konferencji MLinPL w Centrum Nauki Kopernik już po raz 22. wręczono Nagrodę im. Witolda Lipskiego. Kapituła przyznała dwie równorzędne nagrody główne po 25 tysięcy złotych w kategorii informatyki stosowanej: Hubertowi Banieckiemu za prace nad wyjaśnialną sztuczną inteligencją oraz dr. Michałowi Naumanowi za skalowanie uczenia ze wzmocnieniem. Wyróżnienie otrzymał dr inż. Kamil Deja. W kategorii teoretycznej nagrody nie przyznano. Gościem honorowym wydarzenia był wicepremier i minister cyfryzacji Krzysztof Gawkowski. Organizatorem konkursu jest Instytut Badawczy IDEAS, a fundatorem Fundacja Kościuszkowska.
Prof. Piotr Sankowski, dyrektor IB IDEAS i pierwszy laureat nagrody z 2005 roku, przypomniał historię tego wyróżnienia. Powstało ono w dwudziestą rocznicę śmierci Witolda Lipskiego, który zmarł w wieku 35 lat, a mimo życia za żelazną kurtyną współpracował z czołowymi badaczami świata, m.in. z Christosem Papadimitriou. „To jest historia pokazująca, że nawet wtedy, mimo tych problemów, dało się robić świetną naukę” – mówił Piotr Sankowski. Nagroda upamiętnia młodego badacza, który osiągnął bardzo wiele w informatyce.
Krzysztof Gawkowski, wicepremier i minister cyfryzacji, podkreślił, że sztuczna inteligencja narodziła się w duchu współpracy, nie w bólu, i że rewolucja dziejąca się na naszych oczach musi iść w parze z rozsądkiem. „Człowiek musi stać w centrum zmiany” – stwierdził. Porównał sytuację do regulacji papierosów, które wymagały lat pracy i protestów, zanim pewne normy, zakazy i ograniczenia stały się normą. „Technologię trzeba umieć adoptować dla człowieka, a nie adoptować się tak, żeby firmy czy wielkie biznesy miały z tego pożytek, a człowiek żyłby w cieniu” – powiedział. Ostrzegał przed scenariuszem, w którym modele językowe narzucają swoją wolę człowiekowi, i życzył, by systemy AI gwarantowały bezpieczeństwo ludziom. „Człowiek, który jest obok maszyny, cały czas ma prawo powiedzieć: żyje na swoich zasadach” – zaapelował wicepremier Gawkowski.
Dr Grażyna Żebrowska, koordynator Nagrody od 2024 roku i dyrektor ds. współpracy międzynarodowej IB IDEAS, przypomniała, że od trzech edycji konkurs organizowany jest we współpracy z Fundacją Kościuszkowską. „A o tym, że jest to przedsięwzięcie prestiżowe, świadczą nazwiska laureatów, dzięki którym polska informatyka ma miejsce w czołówce światowej. Pierwszym laureatem edycji 2005 r. był prof. Piotr Sankowski” – przypomniała. Wskazała też na programy stypendialne Fundacji, które co roku umożliwiają wyjazdy naukowców do Stanów Zjednoczonych.
Co do nagrodzonych, to Hubert Baniecki jest doktorantem na Wydziale Matematyki, Informatyki i Mechaniki Uniwersytetu Warszawskiego oraz badaczem w Centrum Wiarygodnej Sztucznej Inteligencji Politechniki Warszawskiej. Odbył staże w Meta w Nowym Jorku i na LMU w Monachium. Współtworzył pakiet open-source DALEX. Dr Michał Nauman specjalizuje się z kolei w uczeniu ze wzmocnieniem; studiował na Uniwersytecie Warszawskim i Uniwersytecie Amsterdamskim, stażował na UC Berkeley, a doktorat obronił na UW pod opieką prof. Marka Cygana. Dr inż. Kamil Deja jest natomiast adiunktem na Wydziale Elektroniki i Technik Informacyjnych Politechniki Warszawskiej oraz liderem zespołu GenAI w IB IDEAS – zajmuje się modelami dyfuzyjnymi i ich wewnętrzną organizacją wiedzy.
Podczas wydarzenia podkreślono, że kandydaci reprezentowali bardzo wysoki poziom, a większość zgłoszeń pochodziła z obszaru informatyki stosowanej, co odzwierciedla aktualny kierunek badań nad sztuczną inteligencją. Nagrody Lipskiego od lat pokazują, że polska informatyka potrafi utrzymywać się w światowej czołówce – tym razem w obszarach, które decydują o praktycznej użyteczności i kontroli nad systemami AI.
Wykład dr. Michała Naumana: Skalowanie uczenia ze wzmocnieniem
Michał Nauman dziękował Kapitule Nagrody im. Witolda Lipskiego, organizatorom oraz mentorom – Markowi Cyganowi i Peterowi Abbeelowi. Przedstawił badania nad skalowaniem value-based reinforcement learning, szczególnie w kontekście kontroli i robotyki.
Wskazał, że w machine learningu skalowanie działa wyjątkowo dobrze: duże modele plus duże, zróżnicowane dane dają systemy znacznie lepsze niż mniejsze odpowiedniki. Modele językowe są tego najlepszym przykładem. W online reinforcement learning sytuacja jest trudniejsza, bo agent sam generuje dane poprzez interakcję ze środowiskiem, a jego zachowanie zmienia się w trakcie uczenia. Dodatkowo bootstrapping z przewidywań sieci amplifikuje niestabilność. Historycznie samo powiększanie sieci nie poprawiało wyników.
Michał Nauman badał dwa kierunki skalowania: różnorodność zadań/środowisk oraz rozmiar modelu (zwłaszcza overparametryzowanej sieci wartości). W pracy BRL pokazano, że tradycyjne proste architektury (MLP) przy skalowaniu do ok. 25 mln parametrów początkowo poprawiają wyniki, ale potem się załamują. Zastosowanie ogólnych technik stabilizacji znanych z foundation models (normalizacja, połączenia residualne) sprawia, że wydajność rośnie stabilnie wraz ze skalą.
„Architektura modelu może być równie ważna, a nawet ważniejsza niż sam algorytm uczenia” – podkreślił Michał Nauman. Większe sieci okazują się znacznie bardziej sample-efficient i osiągają lepszą końcową wydajność; korzyści przeważają nawet nad większym kosztem obliczeniowym.
W drugiej pracy (BRC) połączono skalowanie modelu z multitask training. Historycznie uczenie wielu zadań jednocześnie było trudne ze względu na konflikty gradientów. Proste normalizowanie zadań plus skalowanie modelu redukowało te konflikty – większy model zyskiwał pojemność, by reprezentować złożoność różnych środowisk bez konfliktów. Multitask agent osiągał wydajność ekspertów single-task przy zaledwie połowie interakcji ze środowiskiem, a przy odpowiednim pomiarze był nawet 40 razy bardziej efektywny. Różnorodność zadań zachęca model do odkrywania wspólnej struktury, która pomaga też na nowych zadaniach. Reprezentacje z generalistycznego modelu przyspieszają trening na świeżych zadaniach. W dużym skrócie, gdy zarzucamy model zadaniami – nagle „dzieje się magia” – radzi sobie znacznie lepiej od oczekiwań i znacznie lepiej niż przy jednym zadaniu.
Michał Nauman zakończył swoje wystąpienie „gorzką nauczką”: społeczność próbowała wielu złożonych, dziedzinowo-specyficznych technik, ale najskuteczniejsze poprawy pochodziły z ogólnych metod adresujących podstawowy problem stochastycznego gradientu. „W najbliższych latach reinforcement learning może nie polegać na projektowaniu nowych algorytmów, lecz na badaniu, jak skalowalne są te, które już mamy. Value-based RL może mieć więcej do zaoferowania ogólnemu ML, niż wcześniej sądziliśmy” – wskazał naukowiec.
Patrząc na to nieco z boku, gdyby przełożyć wnioski Naumana na biznes, mogłoby okazać się, że rynkowe wyceny i pogoń za GPU nagle tracą swój sens, a przynajmniej są mocno przeceniane, bo można osiągnąć znacznie więcej w treningach bez „pompowania” wyceny Nvidii i przeceniania wartości GPU oraz centrów danych. A w takim razie, pytanie o rynkową korektę wycen staje się jeszcze bardziej otwarte.
Wykład Huberta Banieckiego: Explainable AI – sześć lat badań
Hubert Baniecki przedstawił sześć lat badań nad explainable machine learning. Zaczynał od interaktywnych dashboardów i badania, jak ludzie interpretują wyjaśnienia modeli. Współpracował m.in. z Przemysławem Bieckiem. Współtworzył pakiet DALEX (ok. 30 tys. pobrań miesięcznie), który implementuje algorytmy do analizy modeli. Cytowania i realne zastosowania (medycyna, bezpieczeństwo, ekologia) pokazały, że narzędzia trafiają do praktyki.
Jednym z ważnych wyników było wykazanie, że dystrybucja danych silnie wpływa na wyjaśnienia. Standardowe próbkowanie z rozkładu IID wprowadzało duże błędy w rankingach feature importance. Zastosowanie technik compression dystrybucji (inspirowane teorią) zmniejszało błąd aproksymacji kilkukrotnie i przyspieszało obliczenia. Podejście „Professor and Explain” okazało się praktyczne przy dużych zbiorach danych.
Najnowsze prace dotyczą wyjaśniania modeli transformerowych i multimodalnych (obraz + tekst). Standardowe atrybucje na pojedynczych tokenach bywają niewystarczające i niefaithful: model może „mylić” obiekty, a wyjaśnienie wygląda identycznie. Hubert Baniecki z zespołem zaproponował metody interakcji cech (feature interactions), które punktują pary tokenów i budują graf, w którym krawędzie niosą siłę interakcji. Pozwala to znaleźć podzbiory tokenów zwiększające lub zmniejszające podobieństwo. Metoda opiera się na lokalnej aproksymacji złożonego modelu prostą regresją po perturbacjach. „Nie da się wiernie interpretować modeli multimodalnych bez interakcji” – podkreślił. Prace obejmują też efektywne algorytmy obliczania interakcji (w tym aproksymacje Shapley values), zastosowania w survival analysis (modele medyczne) oraz meta-atrybucje, które można nałożyć na dowolną metodę atrybucji, np. uwagę.
Hubert Baniecki wskazał, że badania nad interakcjami i dystrybucją danych mają znaczenie praktyczne – od wykrywania biasów w danych medycznych (np. urządzenia na zdjęciach rentgenowskich obniżające predykcję przeżycia) po rozumienie, czy modele multimodalne łączą koncepcje z właściwymi fragmentami wejścia. Naukowiec dziękował współpracownikom, instytucjom (UW, PW, Centrum Wiarygodnej AI) oraz fundatorom.
Oba wykłady pokazują ten sam kierunek: polscy młodzi badacze pracują nad skalowalnością i kontrolowalnością systemów AI, które mają działać w realnych, wysokostawkowych zastosowaniach – od robotyki po medycynę. A do tego są w absolutnym światowym topie.