Debata ITwizSztuczna inteligencjaPolecane tematy
W projektach AI czas na architekturę, Governance i odpowiedzialność

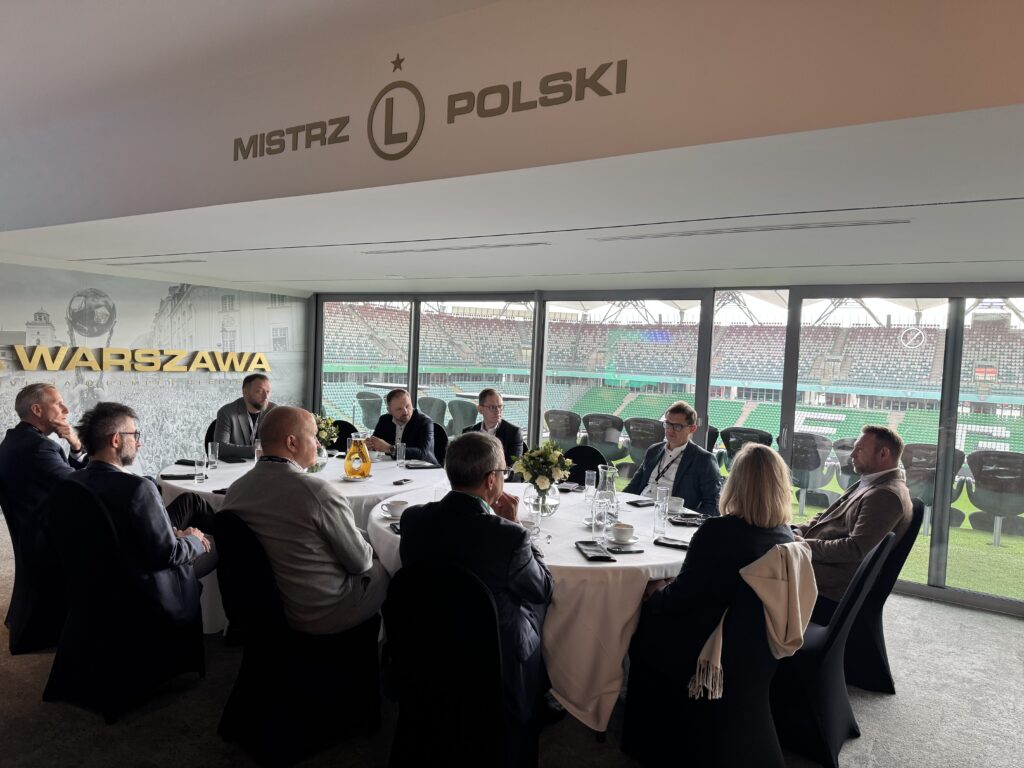
Organizacje coraz szybciej przechodzą od testowania narzędzi opartych na sztucznej inteligencji do wdrażania ich w procesach produkcyjnych. Oznacza to jednak konieczność podejmowania decyzji dotyczących architektury, lokalizacji danych, kontroli dostępu do modeli, bezpieczeństwa, kosztów oraz odpowiedzialności za wyniki działania systemów. Uczestnicy naszej debaty, której partnerem był Hewlett Packard Enterprise rozmawiali o tym, jak budować platformy AI, kiedy korzystać z chmury, a kiedy z modeli lokalnych, jak rozliczać zużycie tokenów i licencji oraz w jaki sposób mierzyć wartość wdrożeń AI.
Wygląda na to, że przechodzimy już od eksperymentów ze sztuczną inteligencją do wdrożeń produkcyjnych. To oznacza, że trzeba znacznie lepiej zadbać o sposób korzystania z modeli, zwłaszcza że coraz częściej mówimy o agentach, którzy bez odpowiednich ograniczeń mogą wykonywać działania nieprzewidziane przez użytkownika. Jak więc zaprojektować platformę AI, która pozwala klasyfikować ryzyko modeli, testować ich jakość i bezpieczeństwo, kontrolować dostęp, a także przypisywać koszty wykorzystania do konkretnych grup użytkowników? Niedawno rozmawiałem z Przemkiem o tym, że budżet przeznaczony wcześniej dla programisty na cały miesiąc może dziś wystarczyć zaledwie na kilka dni.
Przemek Koch, CIO, VeloBank: Rozmawialiśmy o GitHub Copilot for Developers. W VeloBanku korzysta z niego ok. 250 programistów. Narzędzie wspiera ich w programowaniu i generowaniu kodu. Mierzymy, jak to rozwiązanie działa, a użytkowników podzieliliśmy na kilka grup: Heavy Userów, użytkowników standardowych i osoby, które dopiero zaczynają pracę z narzędziem.
Poziom adopcji zależy m.in. od języka programowania. W niektórych przypadkach kilkanaście czy 20% kodu jest generowanych przez modele językowe. W innych udział ten przekracza już 40%. Oczywiście zawsze to programista akceptuje kod, ocenia, czy jest poprawny, i dopiero wtedy przekazuje go dalej.
Microsoft zmienił jednak w maju cenniki. Przeliczyliśmy więc pulę środków, którą wcześniej alokowaliśmy miesięcznie na jednego dewelopera. Wcześniej wystarczała ona średnio na cały miesiąc. Po zmianie cennika ta sama kwota wystarcza na ok. 5 dni. Z 4 tygodni zrobił się więc 1 tydzień. To pokazuje, że trzeba bardzo uważnie monitorować kwestie związane z kosztami.
Grzegorz Laudy, CTO, BLIK: Stało się tak przy korzystaniu z tych samych modeli?
Chat pracowników to kilka godzin szczytu dziennie, a przez resztę czasu karta graficzna się „nudzi”. Agenci AI, automatyczne pipeline’y wytwarzania oprogramowania i przetwarzanie wsadowe pracują przez całą dobę. Dopiero one zmieniają ekonomię wykorzystania własnych środowisk AI – mówi Grzegorz Laudy, CTO, BLIK.
Przemek Koch: Tak. Oczywiście same modele również się zmieniają. Nowsza wersja może zużywać więcej tokenów, ale nawet po uśrednieniu widać, że sama zmiana cennika stworzyła po naszej stronie istotne wyzwanie.
Kontrola kosztów jest ważna, dlatego dziś mówi się dużo o AIOps i produktywności. W sektorze finansowym jeszcze ważniejsze wydają się jednak bezpieczeństwo i kontrola nad danymi?
Grzegorz Laudy: Wrócę na początek do wątku poruszonego przez Przemka, przeprowadziliśmy serię testów z rozwiązaniami hyperscalerów. Sprawdzaliśmy m.in. czy wykorzystanie narzędzi wspierających programistów się opłaca, jaki jest ich koszt w porównaniu z uzyskanym efektem.
Z naszych analiz wynika, że wzrost produktywności wyniósł ok. 25%, a koszt pracy programisty ok. 5%. W przypadku małej i niekrytycznej bazy oprogramowania uznaliśmy więc, że warto iść w tym kierunku. Chcieliśmy jednak wypracować własne wnioski, a nie opierać się wyłącznie na deklaracjach dostawców.
Wracając do tematu bezpieczeństwa, jesteśmy silnie regulowaną instytucją. Dostarczamy usługi, z których korzystają banki i cały sektor finansowy, dlatego nie mamy pełnego komfortu wykorzystywania rozwiązań hyperscalerów do rozwoju oprogramowania na dużą skalę.
Dlatego budujemy własną infrastrukturę. Ważniejsza dla nas jest dopuszczalność regulacyjna, a nie rachunek. Mamy dane, które nie mogą opuścić naszej infrastruktury, niezależnie od ceny tokena. Do tego dochodzi własność intelektualna. Kod źródłowy naszych systemów to nasze IP i nie chcemy go wysyłać do hyperscalerów. Dlatego wytwarzanie oprogramowania z modelami lokalnymi to dla nas naturalny obszar on-premise.
W niektórych przypadkach kilkanaście czy 20% kodu jest generowanych przez modele językowe. W innych udział ten przekracza już 40%. Oczywiście zawsze to programista akceptuje kod, ocenia, czy jest poprawny, i dopiero wtedy przekazuje go dalej – mówi Przemek Koch, CIO, VeloBank.
Chcemy mieć modele hostowane lokalnie, które będą wspierały funkcje i procesy krytyczne, a także te zadania, które wymagają dostępu do danych, których nie możemy przekazywać na zewnątrz. Krytyczność procesu to osobny argument, niezależny od kosztu. Przy tego typu procesach liczy się ciągłość działania i ryzyko koncentracji na jednym dostawcy. Model, który dostawca może wycofać, zmienić albo ograniczyć z dnia na dzień, nie może być jedynym elementem krytycznego procesu.
Uważam, że platformy AI nie powinno się tworzyć jako jednego, monolitycznego rozwiązania. Lepiej składać ją z gotowych komponentów, które można szybko wymieniać. Najpierw trzeba wyjść od regulacji i klasyfikacji danych, później określić sposób hostowania modeli, a dopiero na końcu budować platformę, która będzie egzekwowała politykę AI. Pierwszym krokiem jest jednak zawsze przypadek użycia. Należy odpowiedzieć sobie na pytanie, do czego konkretnie potrzebujemy sztucznej inteligencji.
Istotna jest również kategoryzacja danych. Początkowo zakładaliśmy, że będziemy klasyfikować dane w czasie rzeczywistym. Napotkaliśmy jednak problemy wydajnościowe. Jednym z większych wyzwań okazało się więc wcześniejsze skategoryzowanie całego zasobu danych, tak aby interakcja użytkownika z modelami była płynna i wygodna.
Jak takie podeście w BLIK wygląda z punktu widzenia „rachunku ekonomicznego”?
Grzegorz Laudy: Jeśli zaś chodzi o rachunek, to własny sprzęt zwraca się dopiero przy obciążeniach ciągłych. Chat pracowników to kilka godzin szczytu dziennie, a przez resztę czasu karta graficzna się „nudzi”. Agenci AI, automatyczne pipeline’y wytwarzania oprogramowania i przetwarzanie wsadowe pracują przez całą dobę. Dopiero one zmieniają ekonomię wykorzystania własnych środowisk AI.
Warto też podkreślić, że sprzęt kupuje się na lata, a modele zmieniają się praktycznie co kwartał. Radzimy sobie z tym tak, że kupujemy sprzęt pod klasę modeli open-weight, a nie pod konkretny model. Zakładamy, że otwarte modele doganiają czołówkę z pewnym opóźnieniem, ale dla wielu zadań jest to dla nas wystarczające.
Dane mają swoją grawitację i lokalizację. Szczególnie w środowiskach regulowanych muszą być przechowywane i przetwarzane w konkretnym miejscu. Dlatego decyzja dotycząca budowy platformy powinna wynikać z przypadków użycia, strategii organizacji oraz lokalizacji danych – mówi Krzysztof Kowalczyk, Sales Director, HPE Polska.
Utrzymujemy architekturę hybrydową, w której chmura przejmuje szczyty i zadania wymagające najlepszych modeli, tam gdzie pozwalają na to dane.
Krzysztof Kowalczyk, Sales Director, HPE Polska: Padła tu bardzo ważna kwestia: podjęcie decyzji. Zaczęliśmy od rozmowy o platformie, ale moim zdaniem najważniejszą decyzją jest właśnie odpowiedź na pytanie: po co chcemy coś zrobić?
Budowanie pełnej platformy dla wszystkich możliwych zastosowań może być wyjściem zbyt daleko idącym i nie zawsze uzasadnionym. Weźmy przykład programowania. Czy jest to proces na tyle wrażliwy z punktu widzenia danych, aby od razu budować dla niego własną platformę?
Tworzenie oprogramowania to też jeden z najbardziej „kalorycznych” procesów, jeśli chodzi o wykorzystanie modeli AI.
Krzysztof Kowalczyk: Zgadza się, ale moim zdaniem dla architektury ważniejsze od „kaloryczności” procesu są dane.
Jeżeli pracujemy ze szczególnie wrażliwymi danymi, które muszą mieć określoną lokalizację i pozostawać pod pełną kontrolą, czasami nie mamy wyboru. Musimy albo zrezygnować z danego rozwiązania, albo zbudować platformę, która zapewni wymagany poziom kontroli.
Dane mają swoją grawitację i lokalizację. Szczególnie w środowiskach regulowanych muszą być przechowywane i przetwarzane w konkretnym miejscu. Dlatego decyzja dotycząca budowy platformy powinna wynikać z przypadków użycia, strategii organizacji oraz lokalizacji danych.
Przyjęliśmy trzy poziomy wykorzystania AI. Pierwszy to narzędzia powszechnie dostępne dla pracowników, takie jak Copilot. Drugi to rozwiązania typu Citizen Development. Trzeci to rzeczywiście platforma. Budujemy ją z myślą o wdrażaniu, uruchamianiu i orkiestracji agentów, a także bezpieczeństwie, Compliance i wspólnym zarządzaniu dostępem – mówi Marcin Tyrański, IT Strategy and Data Platform Department Director, UNIQA Polska.
Marcin Tyrański, IT Strategy and Data Platform Department Director, UNIQA Polska: Zawsze trzeba wyjść od danych. Czasami budujemy platformę, a jednocześnie mamy w organizacji mieszaninę danych o różnej jakości, różnym poziomie wrażliwości i różnym znaczeniu biznesowym. Później dziwimy się, że pojawiają się problemy z podejmowaniem decyzji.
W UNIQA nie stosujemy zero-jedynkowej zasady: budujemy platformę i wszystko robimy za jej pomocą, a wszystkie inne narzędzia są gorszej jakości. Przyjęliśmy trzy poziomy wykorzystania AI. Pierwszy poziom to narzędzia powszechnie dostępne dla pracowników, takie jak Copilot. Mogą być wykorzystywane m.in. do transkrypcji, przygotowywania prezentacji i podobnych zadań.
Drugi poziom to rozwiązania typu Citizen Development. Pozwalają tworzyć narzędzia dla konkretnego zespołu, ale nie powinny być wykorzystywane poza tym zespołem. W tym obszarze korzystamy m.in. z Copilot Studio do budowania agentów AI.
Takie rozwiązania zaczynamy rejestrować i monitorować. Mamy ciało Innovation Hub, przez który przechodzą tego typu pomysły, m.in. po to, aby w organizacji nie powstawało 15 rozwiązań rozwiązujących ten sam problem. To podejście jest zresztą podobne do standardowych zasad zarządzania mikrousługami. Trzeba wiedzieć, jakie rozwiązania istnieją, kto za nie odpowiada i w jakich obszarach są wykorzystywane.
Trzeci poziom to rzeczywiście platforma. Budujemy ją z myślą o wdrażaniu, uruchamianiu i orkiestracji agentów, a także o bezpieczeństwie, zgodności regulacyjnej i wspólnym zarządzaniu dostępem.
Mamy dodatkową korzyść wynikającą z tego, że działamy w ramach Grupy UNIQA. Jeżeli jeden kraj opracuje rozwiązanie biznesowe, możemy je dostosować do własnych potrzeb. Jednocześnie my możemy być liderem w jednym obszarze, a inne kraje w innych. Ta wymiana doświadczeń przyspiesza budowę kompetencji.
Chcieliśmy sprawdzić, czy z wykorzystaniem modeli AI można generować ekrany i modernizować elementy systemów legacy. Najpierw musieliśmy jednak zasilić modele odpowiednią wiedzą. Nikt wcześniej nie trenował ich z myślą o tego typu środowiskach. Wyniki zależały od analityka i konkretnego przypadku użycia – mówi Robert Pławiak, CIO, ProService Finteco.
Jednocześnie budujemy własne kompetencje i zespoły. Opieranie się wyłącznie na dostawcach i partnerach jest ryzykowne. Organizacja musi wiedzieć, jak działają rozwiązania, które wdraża, jakie mają ograniczenia i jakie ryzyko generują.
Trzeba też pamiętać, że sztuczna inteligencja to nie tylko duże modele językowe i generatywna AI. Nadal istnieją rozwiązania Machine Learning, klasyczne modele analityczne, robotyzacja i automatyzacja. To, że pojawiła się generatywna AI, nie oznacza, że rozwiązania zbudowane wcześniej należy wyrzucić.
Kilka lat temu wdrożyliśmy rozwiązania oparte na machine learningu, które skróciły proces likwidacji szkody życiowej z kilku dni do kilku godzin. Był to przełom na rynku i inne firmy zaczęły budować podobne rozwiązania.
Pierwszym krokiem powinien więc być też wybór technologii odpowiedniej do przypadku użycia.
Czy wspólna platforma UNIQA obejmuje różne typy sztucznej inteligencji, takie jak Machine Learning, GenAI i rozwiązania agentowe?
Marcin Tyrański: Tak. Mamy rozwiązanie chmurowe zintegrowane z naszym środowiskiem danych. Korzystamy z Databricks, które jest dla nas centralnym miejscem przetwarzania danych, oceny ich poprawności i badania jakości.
Mamy jednak ważną zasadę, w tym centralnym środowisku nie poprawiamy fizycznie danych. Możemy je analizować, badać ich jakość i wskazywać problemy, ale miejsce, w którym dane są faktycznie poprawiane, pozostaje w systemach dziedzinowych.
Wszyscy odczuwamy dziś presję związaną z dynamicznym rozwojem AI. Z perspektywy organizacji najważniejsze jest jednak umożliwienie eksperymentowania i korzystania z nowych narzędzi w sposób kontrolowany i bezpieczny. Dlatego koncentrujemy się na rzetelnej walidacji rozwiązań dostarczanych przez podmioty zewnętrzne oraz budowie skutecznych mechanizmów kontroli – mówi Kryspin Sławek, dyrektor Pionu Eksploatacji i Infrastruktury, PKO BP.
Nie ma sensu poprawić danych jednego dnia w centralnym repozytorium, jeśli następnego dnia system źródłowy ponownie nadpisze je błędnymi informacjami. Dlatego trzeba zacząć od danych, ale jednocześnie trzeba budować Governance, który pozwoli organizacji poruszać się w tym wszystkim bez wzajemnego blokowania się.
Robert Pławiak, CIO, ProService Finteco: W swojej odpowiedzi połączyłbym kilka wątków, które się tutaj pojawiły. To, o czym mówił Przemek, jest bardzo bliskie przejściu od podejścia skoncentrowanego na rozwoju oprogramowania do myślenia w kategoriach produktu.
Nie chodzi już wyłącznie o programistę. Oczywiście jest ważnym elementem procesu, ale każdy, kto tworzył rozwiązania technologiczne, wie, że bez analizy, wymagań i zrozumienia problemu nie da się zbudować dobrego produktu.
To jest moment, w którym trzeba eksperymentować. Myślenie produktowe oznacza skupienie się na tym, co chcemy wytworzyć, dla kogo i jaki problem ma zostać rozwiązany. Zmiana modelu licencjonowania GitHub Copilot była dla nas odczuwalna, ponieważ z rozwiązania korzysta ok. 150 osób.
Zaczęliśmy analizować, kto jest Heavy Userem, kto korzysta z narzędzia standardowo, a kto dopiero się uczy. Nie jest też tak, że można przyjąć jedną uniwersalną wartość i powiedzieć: produktywność wzrosła o 40%. W jednym przypadku wyniki są bardzo dobre, w innym znacznie słabsze. Testowaliśmy generowanie kodu, tworzenie artefaktów i automatyzację zadań.
Inny kontekst to fakt, że wszyscy mamy systemy legacy. Dlatego przeprowadzaliśmy również eksperymenty z wykorzystaniem AI w starszych środowiskach. Mamy systemy oparte na technologiach, które rozwijane są od kilkudziesięciu lat. W naszym przypadku były to m.in. rozwiązania wykorzystujące język 4GL.
Technologicznie można powiązać wywołanie modelu czy zużycie tokenów z konkretną jednostką, ale to tylko część obrazu. Dochodzą do tego licencje, utrzymanie środowiska i infrastruktura potrzebna do działania rozwiązania. Zależy nam na tym, żeby uwzględniać te elementy w ocenie całkowitego kosztu – mówi Michał Polak, CIO, Energa-Operator.
Chcieliśmy sprawdzić, czy z wykorzystaniem modeli AI można generować ekrany i modernizować elementy takich systemów. Najpierw musieliśmy jednak zasilić modele odpowiednią wiedzą. Nikt wcześniej nie trenował ich z myślą o tego typu środowiskach. Wyniki zależały od analityka i konkretnego przypadku użycia. W rozwiązaniach agentowych znaczenie ma też to, jaki zakres autonomii otrzymuje agent i jak długi jest horyzont jego działania.
Poza programistami rozwijaliśmy również kompetencje związane z budowaniem tzw. skills, czyli umiejętności i komponentów wykorzystywanych przez agentów. Dotyczyło to także analizy, testów i tworzenia scenariuszy testowych. Moja podstawowa zasada brzmi: 80% sukcesu stanowią ludzie, a 20% technologia. Wiele osób nadal uważa, że wystarczy wdrożyć narzędzie i problem zostanie rozwiązany. Tak nie jest!
Marcin Tyrański: AI może jednak pomóc w wychodzeniu z systemów legacy.
Robert Pławiak: Oczywiście. Trzeba jednak pamiętać, że rozwój technologii musi być połączony z odpowiedzialnością za cały łańcuch. Część z nas działa w sektorze finansowym albo świadczy usługi dla podmiotów z tego sektora. Musimy więc mieć pewność, że rozwiązanie wdrożone w jednym miejscu będzie bezpieczne w całym ekosystemie.
Łatwo powiedzieć: „u nas działa to tak, a u was inaczej”. W praktyce te systemy muszą ze sobą współpracować. Trzeba wiedzieć, czy dany system jest krytyczny, kto za niego odpowiada, kto go rozwija i jakie konsekwencje będzie miało jego niewłaściwe działanie.
Warto – jak wspomniał Marcin – pamiętać, że AI można wykorzystywać nie tylko w generowaniu kodu. Są rozwiązania Computer Vision, Predictive Maintenance i inne, w których rzeczywista wartość biznesowa może być bardzo duża.
To prowadzi nas do pytania o wartość biznesową. Ile organizacji naprawdę ją zmierzyło?
Robert Pławiak: Często słyszymy, że rozwiązanie zoptymalizowało proces. Dobrze, ale trzeba sprawdzić, czy zoptymalizowany został cały proces, czy tylko jego fragment. Zdarza się, że jeden zespół usprawnia część pracy, a w rezultacie obciążenie przenosi się na inny i cały proces staje się droższy. To są bardzo praktyczne kwestie.
AI rozwija się w każdym w każdym Pionie w banku, np. wszystkim wokół obszaru obsługi klienta i systemów wspierających pierwszą linię. Jeśli spojrzymy na obecne wdrożenia, większość z nich koncentruje się na produktywności. AI pozwala inaczej podejść do realizacji zadań, odciążając pracowników od powtarzalnych czynności – mówi Arkadiusz Gronek, IT Operations Director, Bank Gospodarstwa Krajowego.
Czasami trzeba zejść na poziom operacyjny i zobaczyć, co naprawdę dzieje się w organizacji. Nie jestem zwolennikiem mikrozarządzania, ale dopiero wtedy widać, że automatyzacja działa w jednym miejscu, a obok ktoś nadal przepisuje dane do Excela.
Dlatego trzeba pytać, czy danego procesu rzeczywiście warto dotykać, czy nie generujemy większej złożoności niż korzyści? Governance jest tu kluczowy, ale równie ważne jest uporządkowanie własnego warsztatu pracy. Trudno oczekiwać, że pracownicy będą korzystać z AI zgodnie z zasadami Governance, jeśli ich przełożony, Product Owner albo właściciel obszaru sam nie używa tych narzędzi. Ludzie mogą bać się technologii, jeśli nie widzą jej zastosowania u swoich liderów.
Marcin Tyrański: W UNIQA chcemy szeroko wykorzystywać AI, szczególnie w IT. Dotyczy to automatyzacji procesów i Product Development Life Cycle. Mamy już agentów, którzy na podstawie dokumentacji technicznej przygotowują architekturę rozwiązania, tworzą wytyczne bezpieczeństwa i planują testy penetracyjne. W niekrytycznych częściach kodu te rozwiązania już działają.
Wdrażamy również proces PDLC wspierany end-to-end przez agentów AI. To zmienia rolę dewelopera. Mniej chodzi o ręczne wykonywanie wszystkich czynności, a bardziej o nadzorowanie procesu przez osobę, która ma odpowiednią wiedzę i potrafi ocenić rezultat pracy agentów.
Robert Pławiak: To prawda. Kluczowa jest umiejętność pracy w zmianie i pokazanie ludziom, jak ta zmiana będzie wyglądała.
Zdarza się, że menedżerom brakuje czasu, ponieważ są pochłonięci bieżącymi zadaniami. W takich sytuacjach pomaga nazwanie tego procesu i wyjaśnienie pracownikom, że zmiana ma swoją dynamikę. Najpierw pojawia się entuzjazm, później przychodzi rozczarowanie, a dopiero następnie można dojść do świadomego optymizmu.
Z naszych analiz wynika, że wzrost produktywności programisty dzięki AI wyniósł ok. 25%, a koszt pracy programisty ok. 5%. W przypadku małej i niekrytycznej bazy oprogramowania uznaliśmy więc, że warto iść w tym kierunku. Chcieliśmy jednak wypracować własne wnioski, a nie opierać się wyłącznie na deklaracjach dostawców – mówi Grzegorz Laudy.
Jeśli organizacja nie przygotuje ludzi na ten etap, zmiana może stać się dla nich źródłem dużego stresu. Widziałem sytuacje, w których w okresie transformacji ludzie zaczynali mieć problemy zdrowotne i korzystali ze zwolnień. To sygnał, że proces został źle przeprowadzony.
Jak podejście do AI wygląda w PKO BP?
Kryspin Sławek, dyrektor Pionu Eksploatacji i Infrastruktury, PKO BP: Kluczowe jest określenie, jak chcemy wykorzystywać AI, jakie cele chcemy osiągnąć i na jakich danych będziemy pracować.
Wszyscy odczuwamy dziś presję związaną z dynamicznym rozwojem AI. Z perspektywy organizacji najważniejsze jest jednak umożliwienie eksperymentowania i korzystania z nowych narzędzi w sposób kontrolowany i bezpieczny.
Jako bank działamy w środowisku o wysokich wymaganiach regulacyjnych. Przetwarzamy wrażliwe dane i odpowiadamy za bezpieczeństwo środków naszych klientów. Jednocześnie dostrzegamy, że rozwój technologii AI jest nieunikniony.
Dlatego koncentrujemy się na rzetelnej walidacji rozwiązań dostarczanych przez podmioty zewnętrzne oraz budowie skutecznych mechanizmów kontroli. Istotnym elementem Governance są cyberbezpieczeństwo oraz możliwość weryfikacji rozwiązań tworzonych w całym cyklu wytwarzania oprogramowania (SDLC).
Musimy mieć pewność, że dysponujemy odpowiednimi mechanizmami testowymi, że kod nie zawiera podatności oraz że wdrażane rozwiązania nie wpłyną negatywnie na stabilność i poprawność działania systemów w przyszłości. W naszej ocenie skuteczne i bezpieczne wykorzystanie AI wymaga odpowiednich ram zarządczych, procesów oraz mechanizmów kontrolnych.
W ostatnim liczba nieusuniętych podatności wzrosła z ok. 80 tys. do ponad 200 tys. To efekt masowo wykrywanych – dzięki AI – podatności przed dostawców naszych rozwiązań. Jeśli dotychczas usuwaliśmy podatności przy okazji kilku wydań rocznie, wkrótce będziemy musieli przejść do zupełnie innego modelu – mówi Przemek Koch.
W banku funkcjonuje wiele systemów legacy. Obecnie analizujemy możliwości wykorzystania AI do wsparcia ich modernizacji i refaktoryzacji. Nie jesteśmy jeszcze na etapie szerokiego wdrożenia, ponieważ w organizacji nadal trwa dyskusja dotycząca optymalnego sposobu wykorzystania tej technologii.
Rozwijamy kompetencje w obszarach MLOps, analizy ryzyka i automatyzacji procesów. Opublikowaliśmy również modele sektorowe na platformie Hugging Face. Jeśli jednak chodzi o jednolitą, kompleksową strategię wykorzystania AI, jesteśmy jeszcze na etapie jej opracowywania.
Czy z systemów legacy można łatwo wydobywać dane na potrzeby analizy i wdrożeń AI?
Kryspin Sławek: Kluczowe znaczenie ma wiedza o tym, gdzie znajdują się dane oraz jak są sklasyfikowane. W PKO BP prowadzimy ciągłe działania na rzecz poprawy jakości i zarządzania danymi. Ze względu na rozproszenie systemów oraz ich silosowy charakter, zapewnienie jednego wiarygodnego źródła danych jest nadal wyzwaniem dla dużych organizacji.
Dodatkowo w organizacjach takich jak banki znacząca część informacji występuje w postaci danych nieustrukturyzowanych. Jest ich często więcej niż danych ustrukturyzowanych, a ich efektywne wykorzystanie wymaga odpowiednich narzędzi i procesów. W środowisku rozwijanym przez wiele lat w sposób silosowy odnalezienie właściwej informacji i zapewnienie jej jakości na potrzeby analiz oraz rozwiązań AI nie jest zadaniem prostym.
Dlatego przed wdrażaniem zaawansowanych rozwiązań opartych na AI konieczne jest uporządkowanie danych, określenie ich właścicieli oraz zbudowanie spójnego modelu zarządzania informacją. To właśnie jakość i dostępność danych są dziś jednym z najważniejszych czynników sukcesu projektów AI.
Michał pisał ostatnio, że spółki energetyczne staną się fabrykami Big Data. Będą generowały ogromne ilości danych i zapewne wykorzystywały do ich analizy sztuczną inteligencję.
Michał Polak, CIO, Energa-Operator: Jak wspomniał Kryspin, klasyfikacja informacji jest niezwykle istotna z punktu widzenia powodzenia całego przedsięwzięcia, które nazywamy AI. Trzeba jednak pamiętać również o jakości danych. Największe wyzwanie stanowi ona dla nas w poszczególnych systemach. Jeśli jakość danych wejściowych jest niska, wynik działania agenta czy automatyzacji będzie równie słaby.
Ujednolicenie danych w organizacji ma kluczowe znaczenie dla skutecznego wykorzystania AI. Jeśli nie dysponujemy spójnymi definicjami pojęć takich jak system krytyczny, strategiczny czy kluczowy i używamy ich zamiennie, to lokalny Copilot będzie powielał te same nieścisłości i błędne interpretacje – mówi Krzysztof Kowalczyk.
Słuchając tej dyskusji, widzę, że również w energetyce i infrastrukturze krytycznej pojawiają się pytania podobne do tych, które stawia sobie sektor finansowy. W naszym przypadku oznacza to stopniowe rozwijanie zasad korzystania z AI, budowanie kompetencji i zbieranie doświadczeń, między innymi z Copilot Studio i rozwiązaniami opartymi na agentach. Ważne jest przy tym zachowanie spójności z kierunkami rozwoju i standardami Grupy Kapitałowej.
Jednym z zagadnień, którym się przyglądamy, jest docelowy sposób zarządzania całym cyklem życia rozwiązań AI. Chodzi między innymi o monitorowanie wykorzystania modeli oraz praktyczne stosowanie zasad governance. W tym kontekście rozważamy również rolę AI Gateway – mechanizmu, który pomagałby przekładać zasady zapisane w procedurach na działanie rozwiązań rozwijanych przez IT i biznes.
Ważnym tematem jest także lepsze zrozumienie i przypisywanie kosztów AI. Technologicznie można powiązać wywołanie modelu czy zużycie tokenów z konkretną jednostką, ale to tylko część obrazu. Dochodzą do tego licencje, utrzymanie środowiska i infrastruktura potrzebna do działania rozwiązania. Zależy nam na tym, żeby uwzględniać te elementy w ocenie całkowitego kosztu.
Na obecnym etapie wspieramy się kluczem podziału, który pozwala przypisywać koszty pośrednie jednostkom biznesowym. Przyglądamy się możliwościom stopniowego usprawnienia tego procesu i ograniczenia pracy manualnej. To jeden z praktycznych tematów, które będą nabierały znaczenia wraz z rozwojem zastosowań AI.
Kryspin Sławek: Wspomniany wcześniej przykład zmian cennika GitHub Copilot jest bardzo pouczający. W PKO BP weszliśmy w to rozwiązanie w połowie maja 2026 r. Od razu zderzyliśmy się z rzeczywistością wzrostu cen.
Nie mieliśmy wcześniej zdefiniowanych struktur kontrolnych. Mamy za to dużą organizację, rozbudowaną strukturę departamentów, biur, zespołów i podzespołów, a także bardzo złożony ekosystem software house’ów. Musieliśmy odpowiedzieć sobie na pytanie, jak sprawić, aby koszty tokenów nie były przypisywane przypadkowo i by można było ustalić, który zespół faktycznie zużywa środki. Zbudowanie takiej mapy okazało się wyzwaniem.
Nadal pracujemy nad mechanizmem kontroli i przesuwania środków pomiędzy zespołami. Chcemy móc policzyć rzeczywisty koszt uzyskania efektu, a nie tylko koszt samego dostępu do narzędzia.
W UNIQA chcemy szeroko wykorzystywać AI, szczególnie w IT. Dotyczy to automatyzacji procesów i Product Development Life Cycle. Mamy już agentów, którzy na podstawie dokumentacji technicznej przygotowują architekturę rozwiązania, tworzą wytyczne bezpieczeństwa i planują testy penetracyjne – mówi Marcin Tyrański.
Michał Polak: Nasza sytuacja jest trochę inna. Nie tworzymy kodu. Cały model AI oparliśmy na trzech elementach: fundamencie i dwóch filarach.
Pierwszy filar to AI dla użytkowników końcowych. Mam na myśli m.in. Copilot w Teams, Power Apps i narzędzia należące do szeroko rozumianego ekosystemu Microsoftu, który jest naszym głównym środowiskiem. Eksperymentujemy też z Gemini, agentami i innymi rozwiązaniami Google. Na razie nie są to wdrożenia produkcyjne.
Drugi filar to AI w naszych systemach podstawowych. Tutaj sytuacja wygląda inaczej, ponieważ nie wpuszczamy publicznych modeli AI do infrastruktury krytycznej. Nie odważyłbym się przesłać danych z systemu SCADA, który służy do zarządzania infrastrukturą, do publicznej chmury ani udostępniać ich publicznym modelom. Bardzo mocno rozwijamy natomiast mechanizmy oparte na modelach lokalnych w tych systemach.
Przykładem jest funkcjonalność FDIR w systemie SCADA, która w razie awarii pozwala automatycznie przeanalizować stan całej sieci energetycznej. Wcześniej taka analiza wymagała czasochłonnych obliczeń, często wykonywanych na papierze, co zwiększało ryzyko błędów.
Celem jest ograniczenie wpływu awarii na odbiorców, czyli zmniejszenie liczby osób, które w danym momencie nie mają zasilania. Dzięki wykorzystaniu elementów lokalnych modeli Machine Learning czas przeliczenia sieci został skrócony do ok. 3 minut. System dostarcza dyspozytorowi rekomendację. Uwzględnia obciążenia, warunki brzegowe i inne czynniki wpływające na stabilność sieci.
Dyspozytor, wykorzystując wiedzę ekspercką, może zweryfikować propozycję i podjąć decyzję. Skrócenie czasu z kilkudziesięciu minut do trzech ma duże znaczenie, zwłaszcza w sytuacji stresu i awarii powodującej, że bez zasilania mogą pozostać setki tysięcy osób, szpitale, banki i zakłady przemysłowe.
Wspomagamy się też sztuczną inteligencją w systemach GIS np. do wsparcia rysowania sieci, a także do odczytywania dokumentów. W energetyce wciąż zdarza się, że projektanci przekazują nam dokumentację na papierze. Samo doprowadzenie do tego, aby dokumenty były dostarczane elektronicznie, jest już wyzwaniem.
Poza programistami rozwijaliśmy również kompetencje związane z budowaniem tzw. skills, czyli umiejętności i komponentów wykorzystywanych przez agentów. Dotyczyło to także analizy, testów i tworzenia scenariuszy testowych. Moja podstawowa zasada brzmi: 80% sukcesu stanowią ludzie, a 20% technologia – mówi Robert Pławiak.
Fundamentem całego modelu jest Governance i adopcja rozwiązań. Governance bywa mylony z księgą zakazów i nakazów. Ja przedstawiam go w organizacji inaczej. Dostarczamy tory, po których można budować i prowadzić swoje narzędzia. Tory są określone i stabilne, ale w ich ramach biznes może rozwijać własne rozwiązania.
W ten sposób tłumaczę organizacji, że Governance nie ma utrudniać wdrażania AI. Jeśli chcesz rozwiązanie bezpiecznie uruchomić i bez problemów wprowadzić na produkcję, musisz zastosować określoną checklistę.
Marcin Tyrański: Ważna jest również architektura, w której dane są przetwarzane i udostępniane. Przez pewien czas popularne było podejście Data Mesh, czyli rozproszone zarządzanie danymi i rozproszone właścicielstwo.
Nie zdecydowaliśmy się na ten kierunek. Przyjęliśmy, że dane powinny być zarządzane w jednym centralnym środowisku. Dziś przynosi nam to korzyści, ponieważ mamy jedno miejsce i jedno źródło prawdy dotyczące danych.
Kryspin Sławek: Dane muszą być nazwane i muszą mieć właściciela. W organizacji musi istnieć osoba albo funkcja odpowiedzialna za zarządzanie danymi i wyznaczanie kierunku. Jeśli tego nie ma, każdy tworzy własny świat i własne definicje.
Michał Polak: Zgadzam się. Ale pojawia się jeszcze jeden problem: sposób interpretowania danych. Podam prosty przykład z poprzedniej organizacji. Nowy CIO pierwszego dnia zapytał mnie, ile osób pracuje w IT. Odpowiedziałem, podając liczbę osób zatrudnionych w IT.
Następnie poszedł do działu HR i zadał to samo pytanie. Otrzymał inną liczbę. Różnica polegała na tym, czy zaliczyć kontraktora jako pracownika, czy nie. To tylko prosty przykład, ale pokazuje, że nawet przy jednym źródle prawdy można mieć różne wyniki, jeśli nie ma uzgodnionej definicji.
Przed wdrażaniem zaawansowanych rozwiązań opartych na AI konieczne jest uporządkowanie danych, określenie ich właścicieli oraz zbudowanie spójnego modelu zarządzania informacją. To właśnie jakość i dostępność danych są dziś jednym z najważniejszych czynników sukcesu projektów AI – mówi Kryspin Sławek.
Marcin Tyrański: Podobnie jest z klientem. Czy klientem jest tylko osoba, która ma u nas polisę? Czy również ta, która jej nie ma, ale zgłasza szkodę likwidowaną przez UNIQA? W praktyce mamy wiele wymiarów i wiele możliwych definicji.
Michał Polak: Jakość danych to jedno, a sposób, w jaki biznes rozumie daną informację i wyciąga ją z danych, to zupełnie inna kwestia.
Kryspin Sławek: Ujednolicenie danych w organizacji ma kluczowe znaczenie dla skutecznego wykorzystania AI. Jeśli nie dysponujemy spójnymi definicjami pojęć takich jak system krytyczny, strategiczny czy kluczowy i używamy ich zamiennie, to lokalny Copilot będzie powielał te same nieścisłości i błędne interpretacje.
Dlatego niezbędna jest standaryzacja słowników i pojęć biznesowych. To wyzwanie, z którym mierzy się większość organizacji. Im dłużej funkcjonują one w niezmienionej formie, tym więcej gromadzi się historycznych odstępstw, wyjątków i niejednoznaczności, które utrudniają efektywne zarządzanie danymi.
Krzysztof Kowalczyk: Warto wrócić do pytania, od którego zaczęliśmy. Każdy z nas widzi, że wyzwań związanych z AI jest znacznie więcej niż te, o których dziś powiedzieliśmy.
AI nie jest prostym zbiorem zadań i rozwiązań. To bardzo złożony obszar, który trzeba uporządkować. Zanim zaczniemy budować platformę, powinniśmy stworzyć fundamenty. Jako przedstawiciel HPE naturalnie mówię o platformie, ale chciałbym wyjść poza własną perspektywę. Tym podstawowym fundamentem jest wspomniany już Governance.
Rozmawialiśmy o modelach dla programistów. Dostawca może zmienić model albo sposób jego rozliczania. Jest to jednak model pozostający pod kontrolą zewnętrznej organizacji. To model publiczny, nawet jeśli korzystamy z niego w środowisku określanym jako zaufane.
W energetyce i infrastrukturze krytycznej pojawiają się pytania podobne do tych, które stawia sobie sektor finansowy. W naszym przypadku oznacza to stopniowe rozwijanie zasad korzystania z AI, budowanie kompetencji i zbieranie doświadczeń, między innymi z Copilot Studio i rozwiązaniami opartymi na agentach – mówi Michał Polak.
Nie wyobrażam sobie powierzenia zewnętrznej organizacji pełnej kontroli nad systemem SCADA czy bankowym. Czy rzeczywiście chcielibyśmy, aby ich działanie było zależne od zewnętrznego modelu, którego nie kontrolujemy?
Jak to wygląda z perspektywy BGK? Co powinno być bazą podejścia do AI?
Arkadiusz Gronek, IT Operations Director, Bank Gospodarstwa Krajowego: BGK jest specyficznym bankiem ze względu na różnorodność działalności i procesów. Mamy np. działalność zleconą, fundusze, programy . Drugim ważnym kontekstem jest migracja naszego systemu core’owego. To wieloletni projekt, który właśnie dobiega końca. Większość sił IT banku jest obecnie skierowana na tę migrację.
Słuchając dyskusji, dochodzę do wniosku, że możemy oczywiście stworzyć model wzorcowy, tak jak wcześniej tworzono wzorce SOA czy inne standardy architektoniczne. Ostatecznie jednak każda organizacja będzie uczyła się na własnych błędach i własnych przypadkach użycia. Rozwiązania AI pojawiają się wciąż punktowo. Na podstawie doświadczeń i wyciągniętych wniosków będą aktualizowane kolejne elementy Governance AI wdrożone w tym roku.
W BGK mamy rozwiązania AI w kilku miejscach, a zespoły odpowiedzialne za ten obszar rozbudowują się. Ciekawym przypadkiem użycia jest próba wykorzystania AI do tłumaczenia interfejsów. Przestały być one kompatybilne w środowisku nowego systemu bankowego.
AI rozwija się w każdym w każdym Pionie w Banku, realizowane są inicjatywy AI np. wszystkim wokół obszaru obsługi klienta i systemów wspierających pierwszą linię. Jeśli spojrzymy na obecne wdrożenia, większość z nich koncentruje się na produktywności. AI pozwala inaczej podejść do realizacji zadań, odciążając pracowników od powtarzalnych czynności.
Na razie AI w głównym nurcie nie tworzy nowych możliwości biznesowych. Przede wszystkim przyspiesza i usprawnia istniejące procesy. Wkrótce nastąpi kolejny przełom: moment, w którym AI zacznie samodzielnie budować infrastrukturę. Kiedy agent, chcąc stworzyć nowe środowisko do pracy, sam zaprojektuje i uruchomi to środowisko IT? To będzie jakościowa zmiana nad którą pracujemy.
Mówimy dziś o infrastrukturze jako kodzie i sieci jako kodzie. Kolejnym krokiem będzie infrastruktura tworzona przez agentów AI. AI, chcąc stworzyć nowe środowisko rozwojowe, sama je zaprojektuje i wykreuje. To będzie jakościowa zmiana, nad którą pracujemy – mówi Arkadiusz Gronek.
Mówimy dziś o infrastrukturze jako kodzie i sieci jako kodzie. Kolejnym krokiem będzie infrastruktura tworzona przez agentów AI. AI, chcąc stworzyć nowe środowisko rozwojowe, sama je zaprojektuje i wykreuje.
Robert Pławiak: Moim zdaniem już jesteśmy w tym momencie. Na rynku istnieją narzędzia, które można wykorzystać do automatycznego budowania środowisk IT. Jeśli dobrze sformułuje się prompt i odpowiednio skonfiguruje narzędzie, można zbudować rozwiązanie, które połączy aplikację z innymi usługami.
Wszystkie potrzebne narzędzia są już dostępne. Jeśli istnieje potrzeba biznesowa, można je wykorzystać. Nie twierdzę, że wszystko działa idealnie, ale ta możliwość już jest.
Arkadiusz Gronek: Moim zdaniem na poziomie pełnego cyklu, o którym mówiłeś wcześniej, jesteśmy jeszcze na etapie wschodzącym.
Robert Pławiak: Rozwiązania AI zaczynają działać w sposób ciągły. Nie tylko wykonują polecenie, ale również obserwują system i przekazują użytkownikowi informacje zwrotne.
Przemek Koch: Padł przykład podatności z obszaru cyberbezpieczeństwa. W ostatnim czasie analizowałem statystyki, które musimy raportować do KNF. Liczba nieusuniętych podatności wzrosła z ok. 80 tys. do ponad 200 tys. To efekt masowo wykrywanych – dzięki AI – podatności przed dostawców naszych rozwiązań.
Pojawiły się nowe rozwiązania i biblioteki, które ujawniły wiele problemów w systemach funkcjonujących na rynku. Jeśli dotychczas usuwaliśmy podatności przy okazji kilku wydań rocznie, wkrótce będziemy musieli przejść do zupełnie innego modelu.
Arkadiusz Gronek: Niedawno dyskutowaliśmy o tym, że patchowanie środowisk powinno odbywać się praktycznie w czasie rzeczywistym. Dojdziemy kiedyś do rozwiązania, w którym wchodzimy na środowisko, aktualizujemy je, testujemy, przełączamy, a następnie przechodzimy do kolejnego, a to wszystko niezauważalne będzie dla produkcji i procesu biznesowego.
Może w końcu skończy się ta „świńska górka” podatności?
Kryspin Sławek: Dopóki jesteśmy zobowiązani do utrzymywania systemów archiwalnych i rozwiązań legacy, musimy tworzyć wokół nich swoisty „sarkofag” bezpieczeństwa. Kluczowe jest ograniczenie możliwości bezpośredniej ingerencji nowych mechanizmów AI w te środowiska, ponieważ często nie były one projektowane z myślą o współczesnych modelach integracji i automatyzacji.
Legacy pozostaje więc istotnym źródłem ryzyka, ale jednocześnie rozwój AI stwarza unikalną szansę na przyspieszenie modernizacji. Rosnące wymagania związane z bezpieczeństwem, integracją danych i wykorzystaniem sztucznej inteligencji wymuszają szybsze aktualizacje systemów.
Marcin Tyrański: To również argument za szybszym wyłączaniem starych systemów. Legacy jest jednym z głównych źródeł problemów. Przez lata biznes i rozwój nowych funkcji miały wyższy priorytet niż inicjatywy architektoniczne.
Teraz możemy wykorzystać ryzyko wynikające z utrzymywania starej architektury jako argument, aby szybciej ją modernizować. Decyzje te podejmujemy wspólnie z biznesem a projekty ograniczające lub modernizujące legacy postrzegane są przez biznes przez pryzmat korzyści biznesowych.
Przemek Koch: Bez AI i podejścia agentowego do patchowania nie dogonimy tego króliczka. Możemy mówić o zwiększaniu częstotliwości aktualizacji, ale skala problemu rośnie szybciej niż możliwości manualnej pracy.
Michał Polak: Kluczowe jest również okno serwisowe, w którym trzeba przeprowadzić aktualizację. Przy tak dużej liczbie systemów i podatności pojawiających się z godziny na godzinę jest to poważne wyzwanie organizacyjne.
Marcin Tyrański: Dlatego potrzebna jest automatyzacja testów. Można sprawdzać rozwiązania, tworzyć sprzężenie zwrotne i reagować szybciej.
Krzysztof Kowalczyk: Możemy chyba powiedzieć, że udowodniliśmy już, iż AI jest ważna.
Bez niej też nie dogonimy wspomnianego „króliczka”.
Grzegorz Laudy: Tak, potrzebujemy AI, żeby obronić się przed AI.
Robert Pławiak: Wiemy, że ta technologia jest ważna. Problem polega na tym, że rozwiązania i zasady powstają często dopiero wtedy, gdy pojawi się konkretny problem. Ludzie identyfikują problem, później próbują go rozwiązać, a reguła albo framework, który powstaje w wyniku tego procesu, zostaje w organizacji na lata.
Dziś ten cykl trzeba powtarzać znacznie częściej. Jeszcze kilka lat temu można było aktualizować zasady 1-2 razy w roku. Teraz trzeba wracać do nich praktycznie cały czas, ponieważ technologia zmienia się szybciej, niż jesteśmy w stanie ją opisać.
Ludzie myślą liniowo, a rozwój AI ma charakter wykładniczy. Nie jesteśmy w stanie intuicyjnie przewidzieć, co oznacza kilkadziesiąt kolejnych kroków w takim tempie rozwoju. Dlatego organizacja musi szybko zmieniać zasady, struktury i sposób pracy.
Pracownicy potrzebują odpowiedzi na bardzo konkretne pytania: co mam robić, komu podlegam, kto podejmuje decyzję i jak wygląda odpowiedzialność. Nie da się rozwijać AI w silosach. Trzeba pracować wspólnie.
Jeszcze przed pandemią w jednej z organizacji ustawiliśmy wspólne stoły, przy których programista, analityk i tester mogli ze sobą rozmawiać. Samo posadzenie tych osób razem zwiększyło efektywność o ok. 30%. Teraz trzeba dołączyć do zespołu agenta AI.
W dyskusji, jaką dziś prowadzimy, przy stole z nami za chwilę może usiąść agent AI.
Debatę poprowadził Adam Jadczak